L’essentiel à retenir : la fiabilité de l’intelligence artificielle repose désormais sur une hiérarchie stricte des flux, où le grounding en temps réel via les API Google ou Bing prime sur les archives historiques. Pour garantir la pertinence de vos contenus, vous devez privilégier une structuration rigoureuse et une autorité éditoriale forte, car les modèles privilégient les sources documentées comme Wikipedia ou GitHub. Cette transition vers le Generative Engine Optimization (GEO) impose une transparence totale des données. Notez que le GPT-3 d’OpenAI a été entraîné sur des versions filtrées de Common Crawl, illustrant l’importance cruciale de la sélection qualitative.
L’émergence des moteurs de recherche génératifs impose une mutation structurelle de l’accès à l’information numérique. Cette transition technologique déplace le curseur de la simple indexation par mots-clés vers une synthèse conversationnelle complexe, redéfinissant ainsi les standards de la visibilité en ligne pour les organisations.
La maîtrise de la classification sources de données ia devient un impératif stratégique pour garantir la fiabilité des réponses produites. Ce guide analyse la hiérarchie des flux informationnels et les protocoles d’acquisition nécessaires pour optimiser votre autorité au sein des nouveaux écosystèmes décisionnels.
- Sources données ia : classification et hiérarchie des flux informationnels
- Acquisition stratégique : licences et corpus d’entraînement spécialisés
- Mécanismes de collecte : du moissonnage massif à la sélection qualitative
- Fiabilité des systèmes : transparence et protocoles de vérification analytique
- Enjeux professionnels : valorisation des actifs et visibilité stratégique
Sources données ia : classification et hiérarchie des flux informationnels
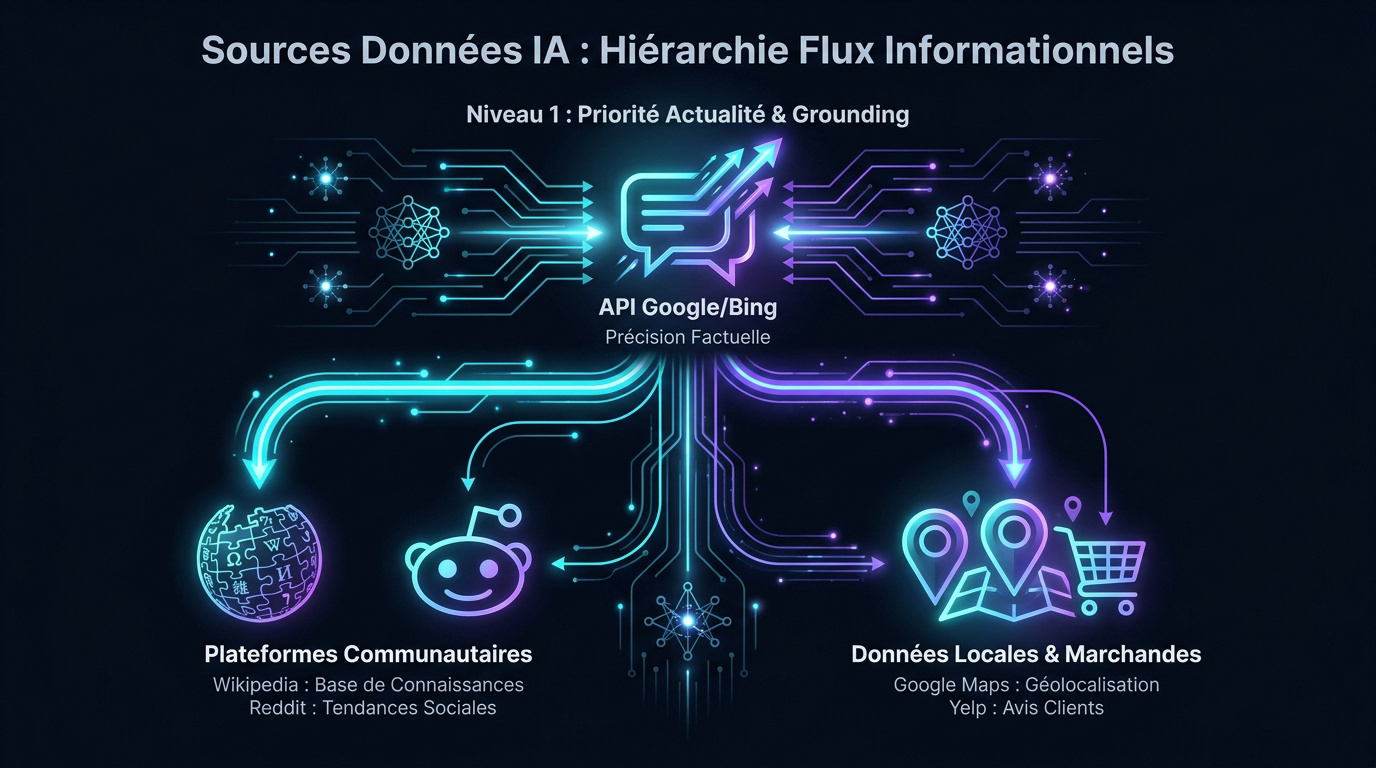
La hiérarchie repose sur le Niveau 1 (API Google/Bing, Wikipedia, Reddit) pour le grounding en temps réel, garantissant la précision factuelle immédiate face aux archives historiques du Common Crawl.
L’intégration des données actuelles via le grounding permet une transition fluide vers l’usage des API en temps réel.
Flux de Niveau 1 : priorité à l’actualité et au grounding
Les API Google Search et Bing Search dominent la vérification immédiate des faits. Cette couche technologique assure l’ancrage factuel indispensable aux réponses générées par les modèles de langage.
Le grounding réduit drastiquement les risques d’hallucinations en corrélant les requêtes aux données web. Ces flux constituent la ressource la plus critique pour la fiabilité des systèmes actuels.
Consultez notre analyse sur GEO, AEO et LLMO : maîtriser la visibilité à l’ère de l’IA pour approfondir ces mécanismes de visibilité.
Plateformes communautaires : Reddit et Wikipedia comme piliers
Wikipedia sert de base de connaissances structurée universelle. Ce socle encyclopédique demeure le fondement de l’entraînement pour la quasi-totalité des modèles de langage à grande échelle.
Reddit apporte une dimension humaine et des opinions non filtrées. Ses données captent les tendances sociales et les expériences authentiques que les sources institutionnelles ignorent souvent.
L’équilibre entre le fait brut et le sentiment humain définit la qualité de l’interaction. Ces piliers communautaires restent des actifs indispensables à l’entraînement des modèles.
Données locales et marchandes : l’apport de Google Maps et Yelp
Les flux de géolocalisation comme Google Maps enrichissent les requêtes de proximité. L’IA utilise ces coordonnées pour répondre aux besoins physiques des utilisateurs. C’est un levier majeur pour le commerce local. La précision géographique devient un atout stratégique.
Yelp et Google Business Profile alimentent les avis clients. Ces données transactionnelles orientent les choix de consommation via les assistants intelligents.
L’intégration des flux marchands transforme l’IA. Elle devient un outil d’aide à l’achat direct.
Acquisition stratégique : licences et corpus d’entraînement spécialisés
Au-delà du web ouvert, les concepteurs d’IA sécurisent désormais des accès exclusifs à des données de haute qualité via des accords commerciaux majeurs.
Partenariats médias : l’ère des accords avec les éditeurs
Les licences avec News Corp ou le Financial Times garantissent des données premium. Ces contenus exclusifs améliorent la pertinence des analyses économiques complexes. La fiabilité des modèles repose sur ces actifs informationnels.
L’enjeu financier pour les éditeurs devient central face à l’exploitation de leurs catalogues. Vous pouvez consulter cette analyse sur la rémunération et défis 2026 pour saisir les mécanismes contractuels actuels.
La qualité des synthèses dépend directement de la fiabilité des sources journalistiques. Ces accords stabilisent les relations entre IA et médias. Ils transforment les textes en actifs négociables et sécurisés.
Documentation technique : GitHub et Stack Overflow au centre
GitHub constitue le réservoir principal pour l’apprentissage du code. Les modèles y puisent des milliards de lignes de programmation. Cette base permet à l’IA de générer des scripts complexes. C’est le moteur de l’expertise technique des agents.
Stack Overflow complète cet apprentissage par la résolution de problèmes. Les échanges entre développeurs offrent un contexte précieux aux algorithmes. La plateforme monétise désormais ses connaissances pour entraîner les modèles d’OpenAI et Google.
Vous noterez l’importance des modèles sémantiques dans la documentation de Microsoft sur les agents d’IA. Ces outils structurent l’intelligence technique moderne.
Corpus académiques : exploitation des bases de données scientifiques
Google Scholar et les archives scientifiques fournissent une rigueur inégalée. Les modèles utilisent ces publications pour valider des affirmations complexes ou médicales. L’IA s’appuie sur ces données pour limiter les erreurs factuelles.
Les statistiques de santé et population mises à jour sont essentielles. La DataBank de la Banque Mondiale sert de référence pour le grounding. Ces chiffres fiabilisent les analyses macroéconomiques globales.
L’exploitation des données évaluées par les pairs renforce la crédibilité des réponses. C’est un rempart contre la désinformation scientifique généralisée. La structuration des métadonnées facilite cette intégration académique rigoureuse.
Mécanismes de collecte : du moissonnage massif à la sélection qualitative
La constitution de ces bases gigantesques repose sur des méthodes d’extraction automatisées, allant du crawl historique au filtrage sémantique fin.
Corpus historiques : l’usage structurel du Common Crawl
Common Crawl offre une archive massive du web mondial. Ce corpus sert de base au pré-entraînement initial des grands modèles de langage. Il démocratise l’accès aux données depuis 2008.
Ces données historiques forment la structure cognitive de l’intelligence artificielle. Elles permettent de comprendre la syntaxe et les concepts fondamentaux. Les modèles apprennent ainsi à prédire le prochain token.
Pourtant, cette masse nécessite un nettoyage rigoureux pour éviter les biais. La quantité ne garantit jamais seule la pertinence finale. Les versions filtrées comme C4 sont donc privilégiées par les développeurs.
Exploration automatisée : agents de veille et moissonnage web
Les agents d’IA parcourent le web pour capter les nouveautés. Ce moissonnage continu permet de rafraîchir les connaissances des modèles multimodaux. Le scraping par IA s’adapte désormais aux changements de mise en page.
L’évolution vers l’intégration d’images et de vidéos change la donne. Les crawlers doivent désormais interpréter des formats visuels complexes. Cela demande une puissance de calcul phénoménale. Les métadonnées deviennent alors cruciales pour l’indexation.
Pour approfondir ces dynamiques, découvrez les Évolutions Google et ChatGPT : l’impact des flux sur le SEO. Ces mutations redéfinissent les standards de visibilité numérique.
Filtrage qualitatif : critères de sélection des données d’entraînement
Les algorithmes de tri écartent les contenus de faible valeur. Le spam et les textes générés par IA sont souvent exclus des jeux d’entraînement. La priorité est donnée à l’exactitude et à l’intégrité.
La sélection repose sur des indicateurs de performance rigoureux garantissant la fiabilité des futurs modèles :
- Score de perplexité du texte source
- Absence de doublons massifs
- Vérification de la cohérence grammaticale
- Diversité des sources
L’équilibre entre volume et pertinence sémantique est le secret des meilleurs modèles. Une donnée propre vaut mieux que mille pages web polluées. La conformité au RGPD demeure également un impératif structurel.
Fiabilité des systèmes : transparence et protocoles de vérification analytique
Une fois les données collectées, la question de la confiance utilisateur se pose à travers la transparence des sources et le contrôle éthique.
Citations et traçabilité : disparités entre outils conversationnels
Certains outils affichent clairement leurs sources par des notes de bas de page. Cette transparence renforce immédiatement la confiance des utilisateurs professionnels. Vous identifiez ainsi l’origine précise de chaque donnée stratégique.
À l’inverse, les modèles opaques génèrent des réponses sans traçabilité. Cela pose des problèmes majeurs pour la vérification des faits critiques. L’absence de preuves directes compromet la fiabilité de vos analyses décisionnelles.
L’attribution des sources demeure le pilier central de la crédibilité informationnelle à l’ère de l’intelligence artificielle.
La visibilité des sources n’est pas qu’une option technique, c’est le fondement de l’autorité de l’IA dans le milieu décisionnel moderne.
Supervision humaine : mécanismes de contrôle et RLHF
Le RLHF permet aux humains de noter les réponses de l’IA. Ce processus corrige les biais cognitifs et améliore la politesse des échanges. L’alignement avec les préférences humaines devient alors une norme opérationnelle.
Le contrôle qualité intervient aussi en amont de l’entraînement. Des milliers d’annotateurs vérifient la véracité des informations sensibles. C’est un travail de l’ombre indispensable. Sans cette étape, les modèles dériveraient vers l’absurde. La supervision reste le garant de la sécurité.
Pour approfondir ces enjeux de gouvernance, consultez notre analyse dédiée : IA marketing B2B : le virage vital vers le contrôle qualité.
Éthique et consentement : protection des droits des créateurs
La protection du droit d’auteur est au cœur des débats juridiques actuels. Les créateurs exigent désormais des mécanismes de retrait pour leurs œuvres. Le respect de la propriété intellectuelle conditionne la pérennité des modèles génératifs.
L’accès aux données publiques s’organise également, comme l’illustre l’ expérimentation du protocole MCP par data.gouv.fr. Ce type d’initiative facilite une exploitation structurée et transparente des ressources étatiques. Vous bénéficiez ainsi d’un cadre de données fiabilisé.
L’apprentissage fédéré offre des pistes pour respecter la vie privée. L’innovation doit composer avec le consentement explicite des détenteurs de données. La conformité réglementaire devient un avantage compétitif majeur pour les organisations.
Enjeux professionnels : valorisation des actifs et visibilité stratégique
Pour les entreprises, comprendre ces flux est l’opportunité de valoriser leurs propres données tout en optimisant leur présence sur les nouveaux moteurs.
Spécialisation métier : exploitation des données propriétaires
L’intégration des bases internes permet de créer des IA sur mesure. Les entreprises sécurisent ainsi leurs actifs stratégiques tout en gagnant en productivité.
| Source de donnée | Type d’accès | Avantage métier | Niveau de sécurité |
|---|---|---|---|
| CRM | API sécurisée | Personnalisation client | 5/5 |
| ERP | Lecture directe | Optimisation supply chain | 5/5 |
| Documents internes | Indexation locale | Gestion des connaissances | 4/5 |
| Flux API | Temps réel | Maintenance prédictive | 4/5 |
Consultez notre analyse sur la performance opérationnelle : Comment utiliser ChatGPT au travail : le guide expert 2026. L’efficacité repose sur la maîtrise des outils.
Référencement conversationnel : vers une stratégie GEO
Le SEO classique mute vers l’optimisation pour les moteurs génératifs. Il faut désormais être cité dans les synthèses d’IA pour exister.
Découvrez comment maximiser votre Visibilité marque ia : comment être cité par les IA en 2026. L’autorité devient le critère numéro un. Les réponses synthétiques captent l’attention immédiate.
La structure des données et la clarté des affirmations favorisent l’indexation. Le langage naturel doit être au cœur de la stratégie éditoriale.
Analyse de performance : mesurer l’impact sur le trafic organique
L’utilisation des données par l’IA impacte directement le trafic des sites sources. Il faut surveiller les clics provenant des AI Overviews.
Mettez en place un Monitoring visibilité marque ia : enjeux et stratégies. Définir des indicateurs de performance adaptés. Le taux de citation devient une métrique clé. La visibilité ne se mesure plus seulement par la position.
L’ère de la recherche IA impose une nouvelle lecture des statistiques web. Bref, l’adaptation est la seule option pour survivre numériquement.
La hiérarchisation des flux informationnels, entre bases historiques et API en temps réel, constitue désormais le socle de la fiabilité des systèmes génératifs. Cette structuration qualitative des données garantit une visibilité stratégique durable. Maîtrisez-vous l’organisation de vos actifs numériques pour répondre aux exigences de ces nouveaux agents conversationnels.
FAQ
Comment les plateformes communautaires telles que Reddit et Wikipedia modèlent-elles les réponses des intelligences artificielles ?
Les plateformes communautaires constituent des piliers fondamentaux pour l’architecture cognitive des modèles de langage. Wikipedia fait office de référentiel institutionnel et encyclopédique, offrant une base de données structurée et factuelle qui garantit la cohérence sémantique des réponses. À l’inverse, Reddit injecte une dimension d’authenticité humaine et d’expérience vécue, permettant aux systèmes d’appréhender des nuances sociales et des opinions de niche que les sources officielles ne répertorient pas.
Cette synergie entre rigueur académique et spontanéité communautaire définit la qualité de l’interaction. Tandis que certains modèles comme ChatGPT privilégient la structure encyclopédique de Wikipedia pour stabiliser leurs affirmations, d’autres outils tels que Perplexity ou Google AI Overviews intègrent massivement les flux de Reddit pour répondre aux requêtes exigeant un retour d’expérience concret ou une validation sociale.
Quelle est la hiérarchie actuelle des sources de données exploitées par les systèmes d’IA ?
La hiérarchie informationnelle s’articule autour de trois niveaux stratégiques. Le premier niveau, dédié au grounding et à la précision factuelle immédiate, repose sur les API de recherche en temps réel (Google, Bing) et les piliers de connaissances stables comme Wikipedia. Ce socle est indispensable pour limiter les phénomènes d’hallucination et assurer un ancrage contextuel fiable aux réponses générées.
Le second niveau concerne les données transactionnelles et locales, issues de plateformes telles que Google Maps, Yelp ou Amazon, qui orientent les décisions d’achat et la navigation physique. Enfin, le troisième niveau englobe les corpus spécialisés et académiques, incluant GitHub pour l’expertise technique et Google Scholar pour la validation scientifique, renforçant ainsi l’autorité des systèmes dans les domaines professionnels complexes.
Quels sont les mécanismes de filtrage garantissant la fiabilité des données d’entraînement ?
La constitution des jeux de données d’entraînement ne repose pas uniquement sur le volume, mais sur une sélection qualitative rigoureuse. Les algorithmes de tri appliquent des protocoles analytiques stricts pour écarter les contenus à faible valeur ajoutée, notamment le spam et les textes préalablement générés par d’autres IA, afin d’éviter une dégradation circulaire des modèles.
Le processus de sélection s’appuie sur des critères techniques précis :
- Évaluation du score de perplexité pour mesurer la fluidité du texte source.
- Élimination systématique des doublons massifs.
- Contrôle de la cohérence grammaticale et syntaxique.
- Diversification des sources pour prévenir les biais cognitifs.
Comment le passage des moteurs traditionnels vers l’IA transforme-t-il la visibilité numérique des entreprises ?
L’évolution vers la recherche générative impose une mutation du SEO classique vers le Generative Engine Optimization (GEO). La visibilité ne dépend plus exclusivement du classement dans une liste de liens, mais de la capacité d’un contenu à être synthétisé et cité par l’IA. L’autorité de marque et la structuration sémantique des données deviennent les leviers primordiaux pour figurer dans les réponses conversationnelles.
Les organisations doivent désormais adopter une stratégie de légitimité éditoriale sur le long terme. Cela implique la production de contenus hautement documentés et fiables, capables d’alimenter les agents de recherche autonomes. La mesure de la performance évolue parallèlement, intégrant le taux de citation dans les synthèses d’IA comme un indicateur clé de la présence organique moderne.
Quel rôle joue la supervision humaine dans la sécurisation des flux informationnels ?
La fiabilité des systèmes d’IA demeure tributaire d’un contrôle humain structuré, notamment via le Reinforcement Learning from Human Feedback (RLHF). Ce mécanisme permet d’ajuster les réponses en fonction de critères éthiques et de politesse, tout en corrigeant les biais identifiés lors des phases de test. L’intervention humaine agit comme un rempart indispensable contre les dérives absurdes ou dangereuses des modèles.
En amont, des protocoles de vérification analytique sont déployés par des annotateurs spécialisés pour valider les informations sensibles, particulièrement dans les domaines médicaux et juridiques. Cette supervision garantit la traçabilité et la transparence nécessaires à l’usage des outils d’intelligence artificielle dans un cadre décisionnel professionnel.