L’essentiel à retenir : l’optimisation des sitemaps XML et des flux RSS constitue le socle technique indispensable pour garantir la visibilité de vos contenus auprès des crawlers d’IA. En soumettant exclusivement des URL canoniques et en maintenant des balises lastmod rigoureuses, vous assurez une indexation réactive et fiable. Cette précision structurelle permet aux modèles de langage de traiter vos données sans friction, évitant ainsi les erreurs de récupération liées à la surcharge serveur ou à des fichiers dépassant 50 Mo. Une segmentation thématique et un monitoring actif via les logs serveurs maximisent l’autorité sémantique de votre écosystème numérique.
Les protocoles de découverte technique évoluent pour répondre aux exigences des modèles de langage.
Si vous constatez des erreurs de récupération dans votre Search Console, une configuration rigoureuse des sitemaps XML et des flux RSS devient indispensable. Ces outils garantissent une indexation réactive et une compréhension sémantique optimale de vos contenus par les agents d’IA.
- Crawlers d’IA : optimisation de la découverte via sitemaps et flux RSS
- Configuration technique : paramétrage du robots.txt et des métadonnées
- Hygiène des sitemaps : résolution des erreurs et segmentation
- Audit et monitoring : analyse des logs et automatisation
- Stratégie de visibilité : alignement structurel et fréquence de mise à jour
Crawlers d’IA : optimisation de la découverte via sitemaps et flux RSS
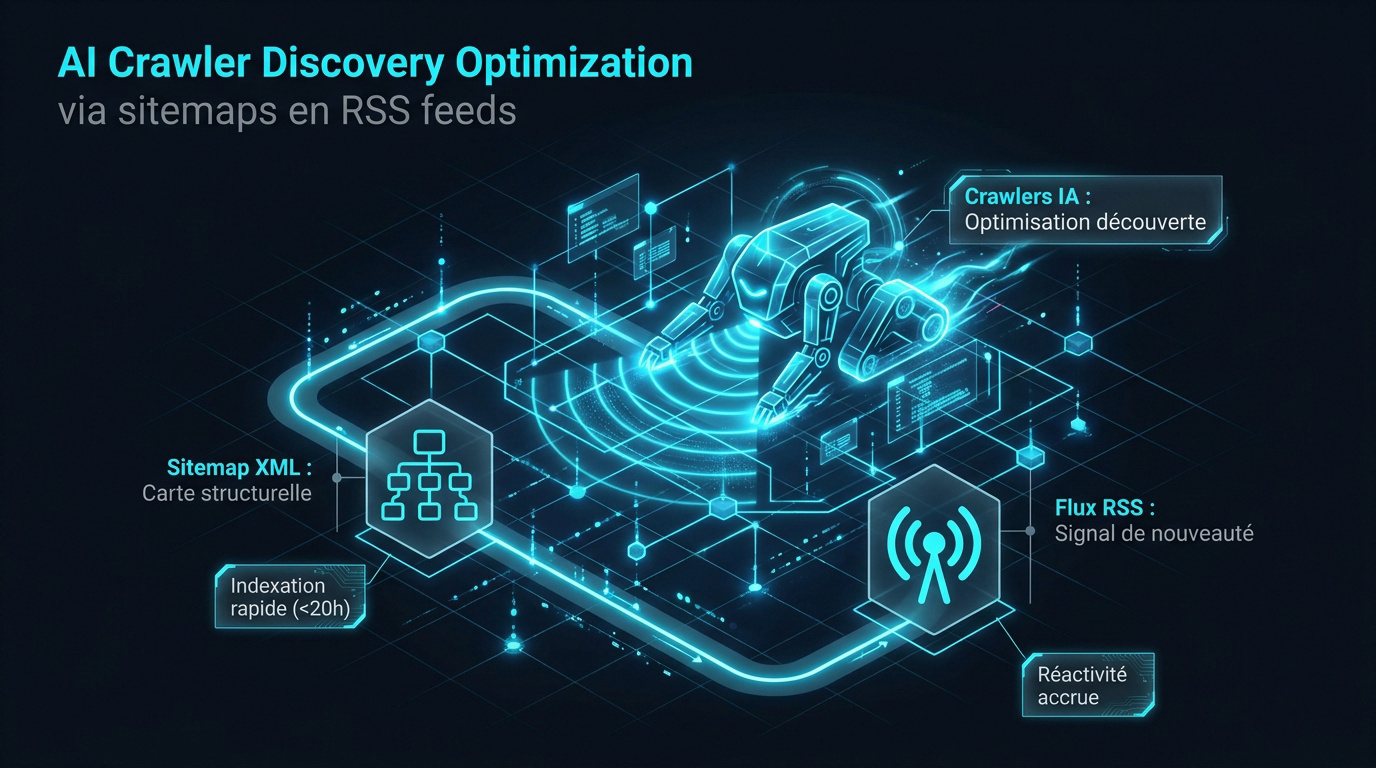
Les robots d’IA privilégient les sitemaps nommés sitemap.xml et les flux RSS liés dans l’en-tête HTML. L’usage de la balise lastmod et de données structurées Schema.org garantit une indexation sous 20 heures, optimisant ainsi la visibilité sémantique. La structure technique des fichiers XML constitue le fondement indispensable de cette visibilité.
Sitemaps XML : un levier de compréhension structurelle pour les modèles de langage
Le fichier XML sert de carte routière précise aux agents d’entraînement. Il convient d’utiliser l’arborescence technique pour guider les bots. Cette organisation facilite la lecture globale de votre architecture de données.
John Mueller recommande d’adopter un nommage générique pour vos fichiers. Un sitemap nommé sitemap.xml est détecté automatiquement sans soumission manuelle. Ce choix technique représente un gain de temps majeur. Il évite les frictions lors de la phase de découverte.
La clarté de votre fichier est déterminante pour votre performance. Vous pouvez consulter notre analyse sur l’ IA locale : optimisez votre SEO 2026 avec Gemini Nano pour approfondir ce sujet. Une structure nette renforce la pertinence sémantique.
Les LLMs analysent la profondeur des répertoires pour pondérer l’importance des contenus. Ils exploitent ces données pour mieux comprendre et indexer un site web. La hiérarchie des pages influence directement la qualité de l’entraînement des modèles.
Flux RSS : la réactivité au service de l’indexation en temps réel
Le flux RSS se distingue par sa grande légèreté technique. Les crawlers d’IA le préfèrent souvent aux sitemaps lourds car il signale les nouveautés instantanément. C’est un outil de veille stratégique performant pour vos mises à jour.
- Découverte rapide des nouveaux contenus.
- Poids réduit du fichier facilitant le transfert.
- Mise à jour automatique des agents d’IA.
L’intégration s’effectue directement dans l’en-tête HTML de vos pages. Le lien spécifique permet une détection immédiate par les robots. Cette méthode constitue une porte ouverte pour les modèles génératifs. Elle assure une transmission fluide de vos informations.
Le RSS bat le sitemap classique sur la fréquence de passage des robots. Cette réactivité est essentielle pour le contenu chaud.
L’usage des flux RSS simplifie la tâche des crawlers d’IA car ils sont directement liés dans le code source des pages.
Configuration technique : paramétrage du robots.txt et des métadonnées
Au-delà de la simple découverte, la précision de vos directives techniques définit le périmètre d’action de ces agents intelligents.
Autorisation des agents d’IA : gestion fine des accès serveurs
La configuration de votre fichier robots.txt est le premier point de contact. Vous devez autoriser explicitement les user-agents comme GPTBot ou CCBot. Ne bloquez pas votre futur trafic par inadvertance.
La directive Sitemap fonctionne de manière autonome. Elle s’adresse à tous les robots compatibles sans distinction. C’est une règle globale et non individuelle. Vérifiez scrupuleusement vos syntaxes de déclaration.
Une erreur ici peut compromettre votre visibilité globale. Consultez notre analyse sur Google Search : impact de la mise à jour anti-spam de 2026 pour mesurer les risques d’un mauvais paramétrage technique.
Balise lastmod : signalement de la fraîcheur du contenu stratégique
Utilisez la balise lastmod pour signaler vos mises à jour. Les robots d’IA privilégient systématiquement la donnée la plus récente. C’est un indicateur direct de fiabilité pour leurs modèles d’entraînement.
Évitez absolument les dates abusives ou systématiquement identiques. Google identifie les fausses actualisations de contenu. Cela dégrade votre crédibilité technique. Restez honnête sur la réalité de vos modifications éditoriales.
Le respect du format W3C Datetime est impératif. Utilisez des horodatages précis incluant le fuseau horaire. Cette rigueur facilite le tri algorithmique et l’indexation de vos dernières analyses économiques.
Schema.org : renforcement de la sémantique pour les réponses générées
Les données structurées apportent un contexte riche à vos pages. Elles articulent les concepts entre eux. Les modèles de langage exploitent cette clarté sémantique pour structurer leurs propres réponses générées.
| Type de Schema | Utilité pour l’IA | Impact visuel |
|---|---|---|
| Article | Clarifie l’auteur et la date. | Extraction facilitée. |
| Organization | Identifie l’entité émettrice. | Autorité renforcée. |
| Product | Détaille les caractéristiques. | Précision des réponses. |
| FAQ | Structure les questions-réponses. | Blocs directs en IA. |
Assurez une cohérence parfaite entre vos métadonnées et les URLs listées dans votre sitemap. La synchronisation des signaux est fondamentale. Pour approfondir, lisez notre guide sur GEO, AEO et LLMO : maîtriser la visibilité à l’ère de l’IA.
Hygiène des sitemaps : résolution des erreurs et segmentation
Une structure propre évite le gaspillage des ressources serveurs et garantit que chaque page stratégique soit correctement interprétée. Une maintenance rigoureuse de vos fichiers XML constitue le socle d’une visibilité pérenne face aux nouvelles exigences des agents d’exploration.
Diagnostic des échecs : analyse des causes de surcharge et de qualité perçue
L’erreur « Couldn’t fetch » dans votre Search Console nécessite une attention immédiate. Souvent, votre serveur sature sous la charge des requêtes. Google abandonne l’exploration si le temps de réponse est trop long. Vous devez optimiser vos ressources d’hébergement pour garantir une fluidité constante.
La qualité perçue de votre site influence directement la fréquence de passage des robots. Un domaine jugé médiocre par les algorithmes subit une baisse de la demande d’exploration. L’IA suit les mêmes règles que le SEO classique pour prioriser les contenus à indexer.
Surveillez scrupuleusement les rapports techniques dans la Google Search Console. Ces données sont vos meilleurs alliés pour identifier les blocages serveurs ou les erreurs de syntaxe. Ne négligez aucun message d’alerte, car chaque échec de récupération freine votre croissance organique au 6 octobre 2026.
Nettoyage des URL : élimination des redirections et des codes 404
Supprimez systématiquement les codes 404 de vos fichiers XML. Les liens brisés épuisent inutilement votre budget de crawl. C’est un signal négatif fort envoyé aux moteurs de recherche. Un sitemap sain ne doit contenir que des pages actives.
Ne listez que des URL canoniques dans vos sitemaps. Évitez absolument les redirections 301 au sein de ces fichiers. Le robot doit accéder directement à la source finale pour maximiser son efficacité. C’est une règle de performance indispensable pour la clarté de votre arborescence.
Le tri rigoureux de vos contenus permet de ne conserver que les pages à forte valeur ajoutée. Consultez notre guide sur l’ élagage de contenu SEO : l’atout stratégique face à l’IA pour affiner votre sélection. Une base de données épurée facilite le travail des crawlers.
Segmentation thématique : organisation par typologie de données
Divisez vos sitemaps par catégories logiques pour une meilleure lisibilité. Séparez distinctement les articles de blog des pages produits. Cela aide les agents d’IA à trier vos informations par thématiques. Une organisation granulaire accélère la découverte des nouveaux contenus.
Respectez les limites techniques strictes imposées par les protocoles actuels. Ne dépassez jamais 50 000 URL par fichier unique. Restez sous le seuil des 50 Mo par sitemap décompressé. Utilisez un index de sitemaps pour regrouper vos différents segments de manière cohérente.
Pour structurer efficacement votre approche, vous pouvez adopter les axes suivants :
- Type de contenu (articles, produits, vidéos).
- Langue du site (pour les domaines multilingues).
- Priorité stratégique (pages à fort taux de conversion).
Audit et monitoring : analyse des logs et automatisation
Pour maintenir cette efficacité dans le temps, une surveillance active couplée à une mise à jour dynamique devient indispensable.
Analyse des logs serveurs : identification des passages effectifs des robots
Scrutez vos journaux d’accès. Identifiez les adresses IP des crawlers d’IA. Vérifiez si ces agents trouvent vos fichiers XML sans difficulté technique.
Détectez les tentatives d’accès sur des sitemaps privés. Certains robots explorent des chemins non conventionnels. Protégez vos données sensibles. Utilisez des noms de fichiers robustes pour éviter les fuites.
L’analyse des logs est l’unique moyen de prouver que les modèles de langage consomment réellement vos données structurées.
Ajustez votre stratégie selon les données récoltées. Si un robot ignore une section précise, changez son poids relatif. Soyez proactif dans votre monitoring quotidien.
Génération dynamique : mise à jour automatisée des fichiers de découverte
Automatisez la création de vos sitemaps. Chaque nouvel article doit apparaître immédiatement dans vos flux. La fraîcheur de l’information constitue votre meilleur atout SEO.
Synchronisez votre base de données en temps réel. Utilisez des scripts côté serveur pour cette tâche. Évitez les interventions manuelles, sources d’erreurs fréquentes. C’est la base de l’agilité numérique.
Consultez notre analyse sur le Roi ia entreprise : optimiser la valeur par les processus pour approfondir ces mécanismes.
Testez régulièrement vos flux automatisés. Une simple erreur de script peut bloquer l’indexation globale. La vigilance technologique reste de mise pour garantir la visibilité.
Stratégie de visibilité : alignement structurel et fréquence de mise à jour
Enfin, la cohérence entre votre structure d’URL et votre rythme de publication scelle votre autorité auprès des IA.
Simplifiez vos chemins d’accès. Les URLs doivent être parlantes. Les modèles de langage déchiffrent le sens des mots-clés.
Bannissez les paramètres complexes comme les IDs obscurs. Préférez des structures logiques et descriptives. Cela renforce la clarté thématique de votre site.
Le John Mueller de Google explique comment les crawlers d’IA accèdent aux sites web via les sitemaps et les flux RSS, et offre des conseils pour optimiser leur découverte, tout en clarifiant les raisons des erreurs de récupération de sitemaps. Consultez notre analyse sur la Meta description SEO : le levier stratégique du CTR en 2026.
Une URL propre est plus facile à citer. Les IA privilégient les sources lisibles. C’est un facteur de confiance indirect.
Définissez votre cadence de publication. Elle doit correspondre à votre secteur. Les actualités demandent un rythme effréné.
Alignez vos mises à jour sur le passage des robots. Observez vos logs pour trouver le créneau idéal. Maximisez l’impact de chaque nouveau contenu publié.
N’oubliez pas le maillage interne. Pour aller plus loin, découvrez notre dossier sur la Stratégie visibilité IA : anticiper les tendances de demain.
La régularité prime sur la quantité. Un flux constant attire les crawlers. Maintenez cet effort sur le long terme.
L’optimisation des sitemaps XML et des flux RSS constitue le fondement technique de votre visibilité auprès des agents d’intelligence artificielle. En garantissant la conformité de vos fichiers et la précision des métadonnées, vous facilitez une indexation réactive de vos contenus stratégiques. Veillez-vous désormais à la parfaite accessibilité de vos flux pour ces nouveaux explorateurs ?
FAQ
Comment les robots d’IA parviennent-ils à découvrir les sites web via les sitemaps et les flux RSS ?
Les crawlers d’IA utilisent les sitemaps XML et les flux RSS comme des leviers stratégiques pour identifier l’arborescence technique et les nouveautés d’un domaine. Contrairement aux moteurs de recherche classiques, ces agents ne disposent pas toujours de consoles de soumission directe ; ils s’appuient donc sur des fichiers aux noms génériques, tels que sitemap.xml, ou sur des flux RSS liés dans l’en-tête HTML via la balise <link rel="alternate">.
L’utilisation de ces protocoles permet aux modèles de langage de structurer leur exploration et de prioriser les contenus récents. En intégrant une directive Sitemap dans votre fichier robots.txt, vous offrez une visibilité globale à ces agents, facilitant ainsi leur accès à vos données sans nécessiter d’intervention manuelle répétée.
Quelles sont les méthodes recommandées pour optimiser la visibilité de mon contenu auprès des crawlers d’IA ?
Pour garantir une indexation efficace par les modèles génératifs, vous devez impérativement soumettre des URL canoniques au sein de vos sitemaps. Cela évite toute confusion sémantique et assure que les robots traitent la version source de vos pages. L’implémentation de la balise lastmod, au format W3C Datetime, est également cruciale pour signaler la fraîcheur de vos informations et inciter à une mise à jour rapide des données indexées.
Par ailleurs, privilégiez les flux RSS pour leur réactivité. Ces fichiers, plus légers que les sitemaps complets, sont explorés avec une fréquence accrue, ce qui est idéal pour la capture de contenus chauds. Veillez à ce que vos fichiers XML ne dépassent jamais 50 Mo ou 50 000 entrées afin de respecter les standards techniques de récupération.
Pour quelles raisons un sitemap peut-il afficher une erreur de récupération dans la Search Console ?
Une erreur de type « Impossible de récupérer » résulte souvent d’une surcharge du serveur hôte, empêchant les systèmes de Google d’accéder au fichier dans les délais impartis. Une autre cause majeure réside dans la qualité perçue du site : si les algorithmes jugent le contenu médiocre ou peu pertinent, la demande d’exploration diminue drastiquement, entraînant un désintérêt pour le sitemap.
Des défaillances techniques plus spécifiques peuvent également bloquer le processus, notamment des URL mal formées, des chaînes de redirections excessives ou des erreurs de syntaxe XML. La présence de caractères non échappés ou l’utilisation de liens relatifs au lieu de liens absolus constituent des obstacles fréquents à une analyse syntaxique correcte par les crawlers.
Le fichier llms.txt peut-il se substituer à un sitemap XML traditionnel ?
À ce jour, le fichier llms.txt ne peut en aucun cas remplacer un sitemap XML. Bien que ce format Markdown puisse offrir une structure lisible pour certains agents, les systèmes de Google et les principaux crawlers d’IA exigent un formatage strict pour automatiser l’indexation à grande échelle. Le manque de rigueur syntaxique du Markdown empêche son utilisation comme outil de découverte structurelle officielle.
Il convient donc de maintenir vos sitemaps XML et vos flux RSS comme piliers de votre stratégie de visibilité. Ces outils restent les standards universels permettant de garantir que vos données structurées et vos métadonnées Schema.org soient correctement interprétées par les modèles de langage et les moteurs de recherche.